如何为大模型服务做容量估算与过载保护?
围绕如何为大模型服务做容量估算与过载保护,覆盖口述答案、公式推导、工程权衡、故障定位和连续追问。
发布于 2026-08-31 · 更新于 2026-09-07
本文目录
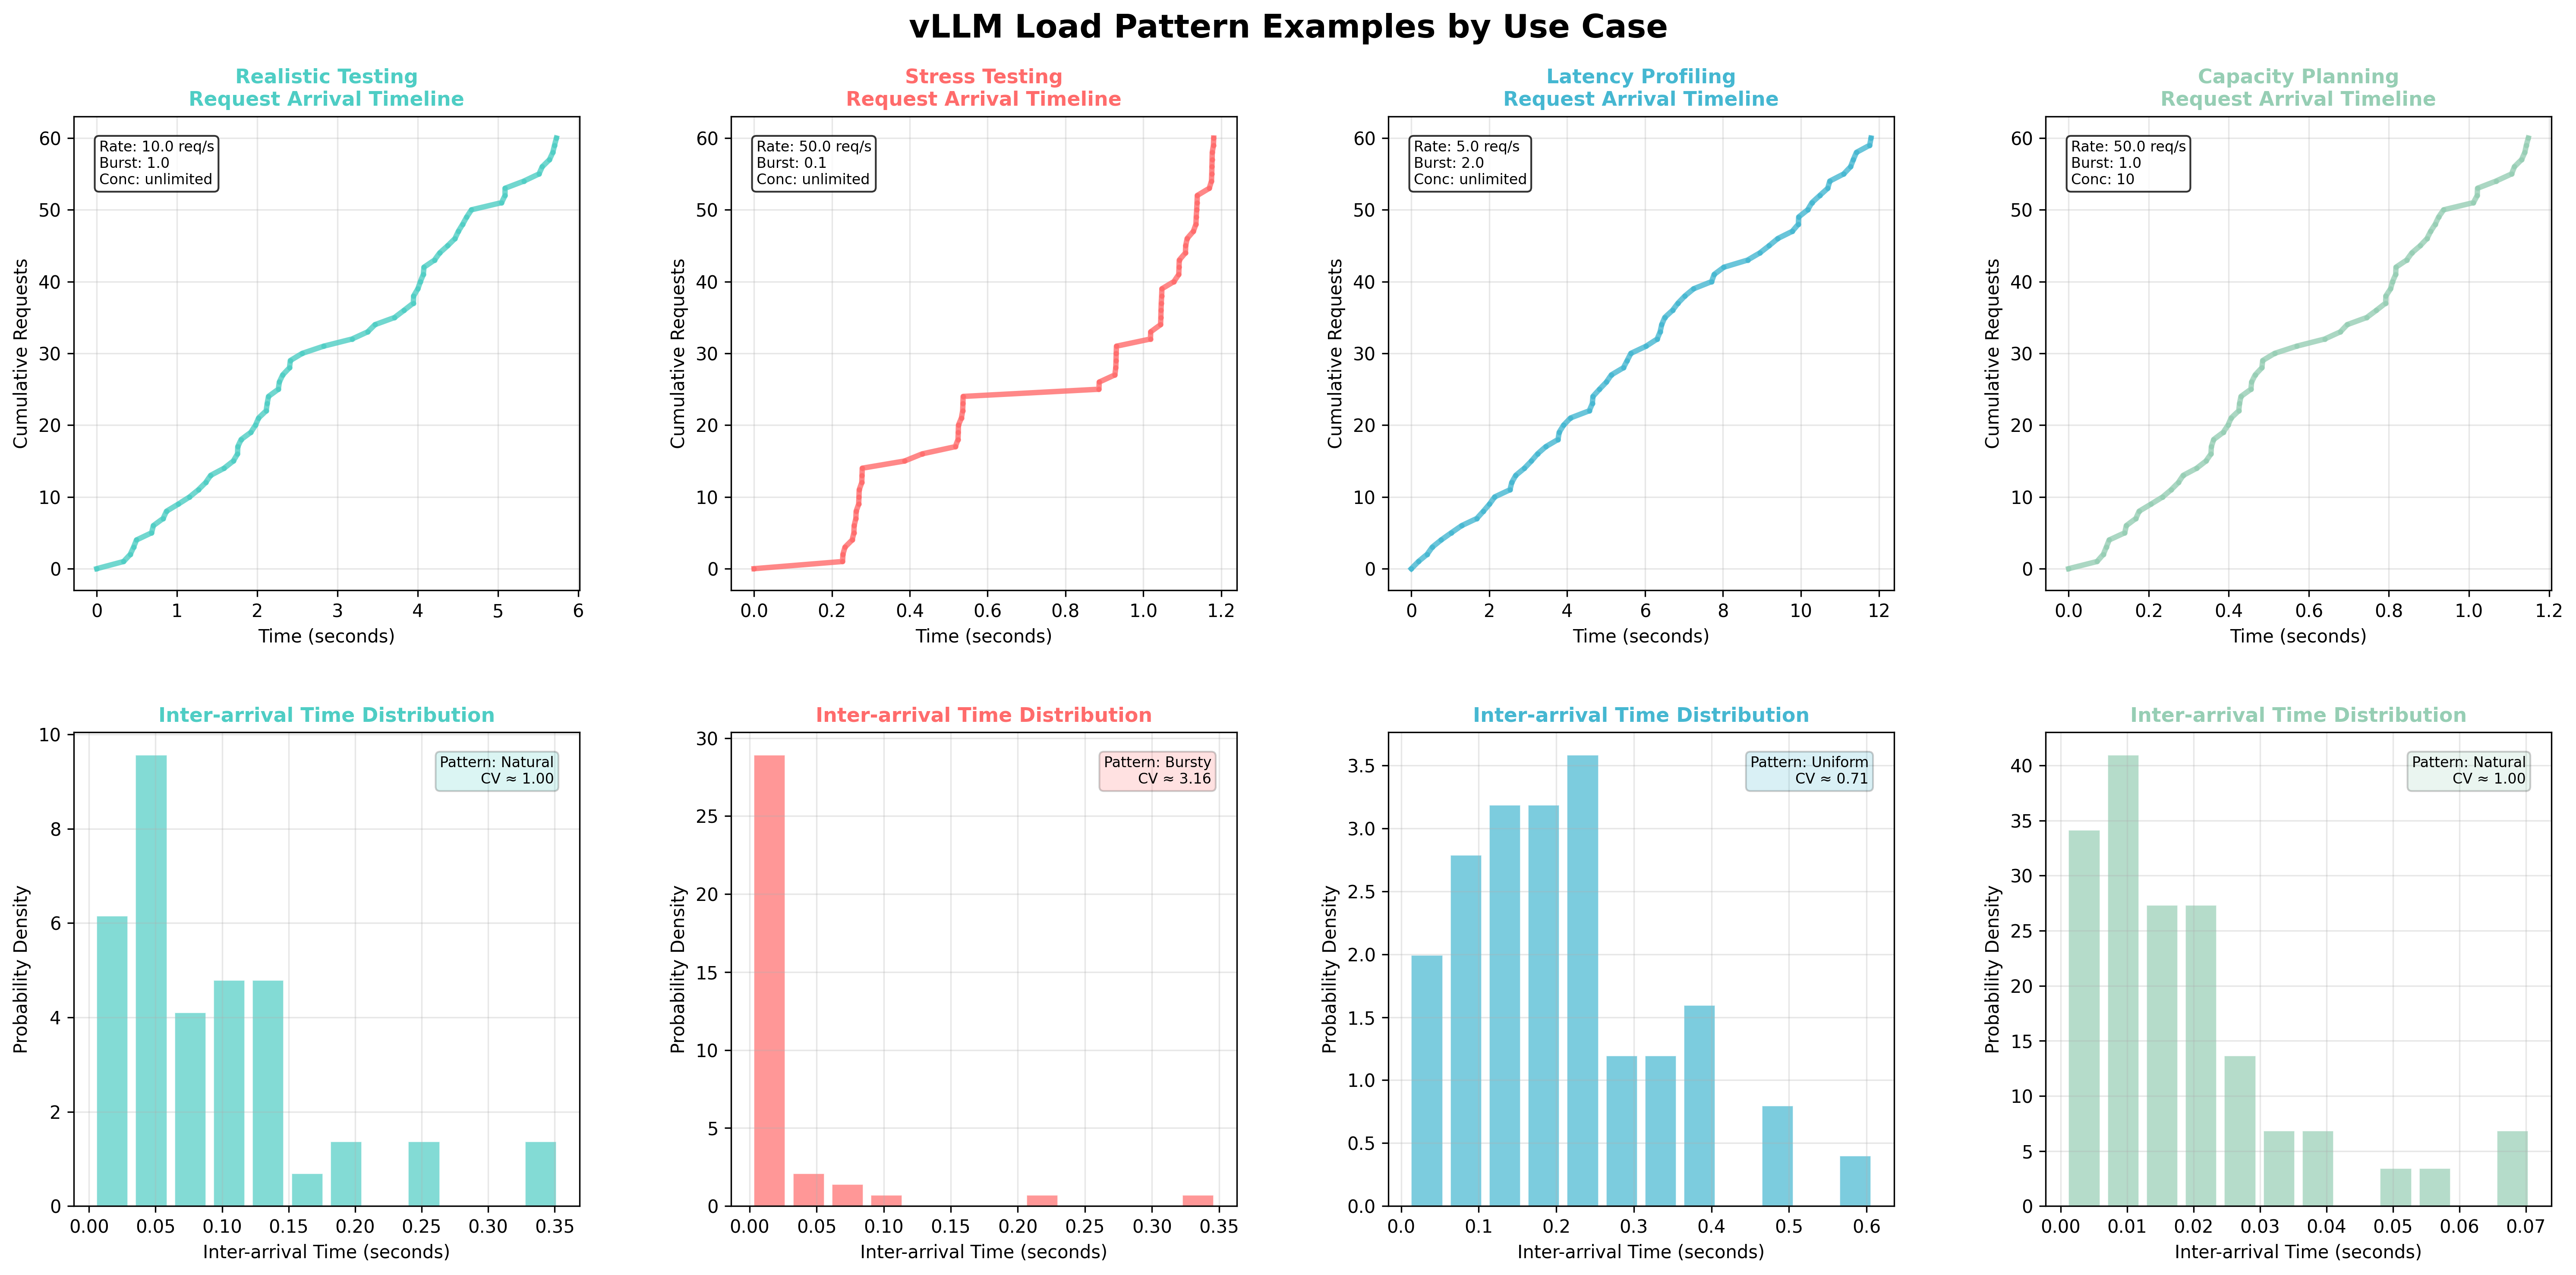
图:用于辅助理解本题的数据流或工程结构。来源:Serving load pattern examples,作者 vLLM Project contributors,许可 Apache-2.0。

考察意图
面试官希望确认候选人能否解释“如何为大模型服务做容量估算与过载保护”中的因果关系,并把公式或流程落实到可测量的工程结果。
60–90 秒口述答案
先从峰值 QPS、输入/输出 token 分布、流式比例和 TTFT/TPOT SLO 建负载模型,再用目标硬件实测单副本在该分布下的饱和点。副本数不能用离线 tokens/s 直接相除,要保留故障、发布和突发余量。入口设置并发/队列上限,超载时拒绝、排队、切小模型或缩短上下文。
深入解释
稳态并发可用 Little 定律 L=λW 粗估;所需副本≈峰值到达率/单副本可承载率×安全系数,再按 N+1、区域故障和滚动发布上取整。最终以开环压测验证 P99。
白板回答时先声明输入规模、张量或请求状态,再推到输出与瓶颈;不要只罗列术语。
工程权衡
无限排队会把过载变成超时雪崩;自动扩容又受 GPU 启动、权重加载和缓存预热限制。需要 admission control、最大排队时间、熔断、优先级和预热池,并按“成功任务成本”观察降级质量。
关键指标包括:峰值 QPS、并发、输入/输出 token 分布、TTFT/P99 SLO、可用性、降级率、GPU 利用率与单请求成本。
完整复习答案
先从约束反推架构
围绕“如何为大模型服务做容量估算与过载保护”,系统设计从峰值流量、token 分布、延迟目标、可用性和数据边界出发。组件图是这些约束的结果;先画组件再补需求,容易漏掉容量、故障域和降级顺序。
把估算代入真实负载
峰值 20 QPS、实测单副本在目标长度分布与 P99 SLO 下承载 3 QPS,裸算需 7 个副本;再考虑 N+1、滚动发布和区域故障可能需要更多。最终用开环压测验证,因为闭环客户端会在变慢时自动降低到达率。
这个估算给出量级。代入项目参数时需要写明忽略项,并保持单位一致。
故障发生时系统怎样退让
围绕“如何为大模型服务做容量估算与过载保护”,单副本承载率取目标长度分布下满足 P99 的安全点,再计入 N+1、滚动发布和启动时间。每个外部依赖明确超时、有限重试、熔断、隔离和降级。
追问参考
流量突增三倍时,先保护什么、牺牲什么?
对“如何为大模型服务做容量估算与过载保护”而言,流量突增时先用 admission control 保护已接收请求和高优先级业务,再按预案减少候选、缩短上下文、切备用模型或异步处理。
如何从 SLO 反推副本数、队列上限和降级阈值?
回到“如何为大模型服务做容量估算与过载保护”,需要区分:从 SLO 压测得到单副本安全承载率,结合峰值、N+1、发布余量和启动时间计算副本;队列上限由最大等待预算反推。
怎样判断方案已经达到上线条件?
“如何为大模型服务做容量估算与过载保护”进入发布方案前,所有依赖都要说明超时、有限重试、熔断、隔离、降级和观测;重试预算必须小于上游截止时间。
常见错误回答
- 只复述“如何为大模型服务做容量估算与过载保护”涉及的术语,没有说明输入、运算和输出之间的关系。
- 讨论 容量规划 时省略模型规模、数据分布或硬件条件,使结论失去适用范围。
- 只讲收益,没有检查 容量规划、SLO 带来的精度、资源或可靠性代价。
连续追问
- 若改变 容量规划 的关键配置,哪些中间量会先发生变化?
- 如何设计对照,检验观察到的差异是否来自 容量规划?
- 哪类输入或负载最容易使这一方案失效?
项目结合
准备一个与 容量规划 直接相关的测量或排障案例。讲清基线、异常指标、被排除的假设和最终判定;没有亲历时,说明会采集哪些数据,不虚构结果。
复习自测
- 能否脱离笔记解释 如何为大模型服务做容量估算与过载保护 的关键运算?
- 能否把文中的数量级例子换成自己的模型或业务参数?
- 能否指出一种不适用场景,并给出可观测的判定条件?