Agent 工具调用如何做到幂等、可恢复和可审计?
按参数、权限、临时故障和结果未知分类。用总时限约束有限重试,写操作依赖幂等与状态查询;checkpoint 恢复流程位置,不替代远端业务保证。
发布于 2026-08-31 · 更新于 2026-09-07
本文目录
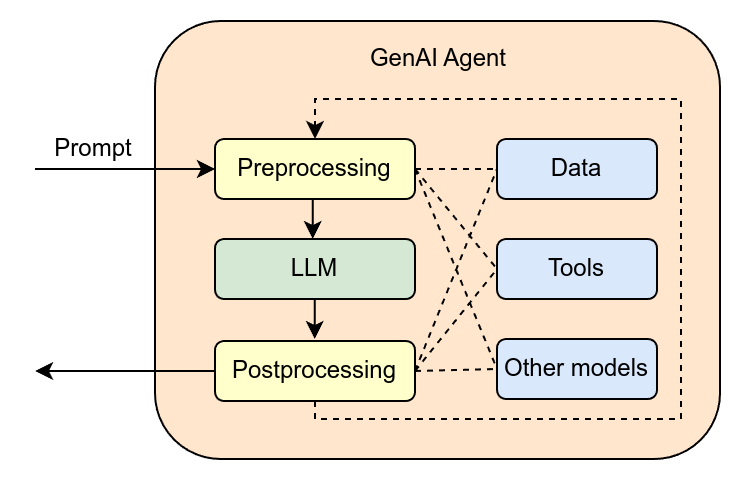
图:用于辅助理解本题的数据流或工程结构。来源:Generative AI agent architecture,作者 Marxav,许可 CC BY-SA 4.0。

考察意图
面试官希望确认候选人能否解释“Agent 工具调用如何做到幂等、可恢复和可审计”中的因果关系,并把公式或流程落实到可测量的工程结果。
回答前自测
- 重试几次合适?
- 工具空结果怎么处理?
- checkpoint 为什么不够?
30 秒回答
按参数、权限、临时故障和结果未知分类。用总时限约束有限重试,写操作依赖幂等与状态查询;checkpoint 恢复流程位置,不替代远端业务保证。
评分点
错误分类、deadline、unknown、恢复与故障注入。
90 秒回答
模型只产生调用意图,执行层为每个业务操作分配幂等键并持久化状态机:planned→authorized→running→succeeded/failed/unknown。超时不等于失败,重试前先查询结果;跨多个副作用步骤用 Saga 补偿而非假设分布式事务。每步记录输入摘要、授权主体、工具版本、结果和关联 trace。
深入解释
重试不应逐层叠加
多层各重试三次可能放大尝试次数。指定主要负责层,采用退避和抖动,检查剩余 deadline。参数错需修正或澄清,权限拒绝不应不断猜参数试探。
恢复前核实业务效果
保存动作 ID、参数摘要、状态与结果引用。崩溃后先确认上一步是否已经执行,再继续。纯计算可重放,邮件和表单不能无条件重放;补偿只能用于有明确业务语义的动作。
测试实际状态
故意在成功后丢响应、结果写入前退出、让两个 worker 同时恢复。检查外部记录数量和参数,不能只看 HTTP 成功率或最终文字。
工程权衡
读操作可自动重试,支付、删除、发信等写操作需要确认和更严格的恢复策略。补偿动作也可能失败,因此要有人工接管队列。审计日志需脱敏且防篡改,不能保存所有原始秘密。
关键指标包括:任务成功率、工具选择准确率、参数正确率、平均步骤数、重试率、超时率、人工接管率与单任务成本。
常见错误回答
- 只复述“Agent 工具调用如何做到幂等、可恢复和可审计”涉及的术语,没有说明输入、运算和输出之间的关系。
- 讨论 工具可靠性 时省略模型规模、数据分布或硬件条件,使结论失去适用范围。
- 只讲收益,没有检查 幂等、Saga、Agent 带来的精度、资源或可靠性代价。
连续追问
重试几次合适?
由依赖、剩余时限和成本决定,没有固定通用次数。
工具空结果怎么处理?
区分合法空集、查询不符与服务异常,缺必要信息时澄清或停止。
checkpoint 为什么不够?
本地状态与远端副作用不在同一事务,需要对端幂等或状态查询。
项目结合
准备一个与 工具可靠性 直接相关的测量或排障案例。讲清基线、异常指标、被排除的假设和最终判定;没有亲历时,说明会采集哪些数据,不虚构结果。
复习自测
- 能否脱离笔记解释 Agent 工具调用如何做到幂等、可恢复和可审计 的关键运算?
- 能否把文中的数量级例子换成自己的模型或业务参数?
- 能否指出一种不适用场景,并给出可观测的判定条件?
关联知识
延伸复习
继续阅读完整机制与案例。完成后回到本页,在不看答案的情况下重述并回答三个追问。