Agentic Reasoning 论文解读:从交互式推理到自我演进与多智能体协作
综述以基础推理、自我演进和群体协作组织研究;需要区分上下文与系统的优化,以及模型参数的更新。
文章目录 · 12 章 · 约 47 分钟
一个模型能解释怎样修复 Bug,不代表它能在真实仓库里定位故障、修改代码、理解失败测试,并继续修正。区别在于:前者主要生成答案,后者还必须在不完整的信息下选择行动,再依据环境反馈改变下一步决策。
Tianxin Wei、Ting-Wei Li、Zhining Liu 等人的综述,将这种“思考—行动—反馈”的交互过程放进同一个研究框架。本文按原文第 2–8 章展开,版本固定为 arXiv v2(2026 年 9 月 20 日),并核对章节与核心定义。arXiv 页面及作者项目页已注明论文被 TMLR 接收。
阅读边界:这是一篇综述解读,不是统一复现实验。前三条主线是基础推理、自我演进和群体协作;后面的轨迹风险估计与验证调度属于本文延伸讨论,不是论文的实验结论。
论文完整题名为 A Survey of Agentic Reasoning for Large Language Models: Towards Recursively Self-Improving and Collective Agents。阅读 HTML · 下载 PDF · 作者维护的论文索引。
一、先理解论文真正想表达什么
1. 从 LLM Reasoning 到 Agentic Reasoning
传统大模型推理通常可以抽象为:
给定问题 ,模型通过推理生成答案 。
即使加入 Chain-of-Thought、Self-Consistency、Tree-of-Thoughts,本质上仍然可以是在一个静态问题中寻找更好的答案。
Agentic Reasoning 则把问题变成:
给定目标和不断变化的环境,智能体需要决定下一步应该思考什么、执行什么动作、获取什么信息,以及如何根据反馈改变后续决策。
它不再只是求解一个静态输入,而是在不断变化的状态中进行序贯决策。
| 场景 | 主要过程 | 新信息从哪里来 |
|---|---|---|
| 静态输入下的推理 | 问题 → 内部推理 → 答案 | 主要来自给定上下文与模型参数 |
| 交互式推理 | 目标与观察 → 思考 → 行动 → 新观察 → 下一轮决策 | 工具结果、环境变化与执行反馈 |
关键区别是:Agent 不只需要生成正确的推理,还需要让推理指导行动,并让行动结果反过来修正推理。
不过,这并不意味着所有 CoT 方法都只能单轮使用,也不意味着 Agent 必须更新模型参数。两者的核心区别是推理是否与环境交互形成闭环。
2. 三类研究范围与两种优化设置
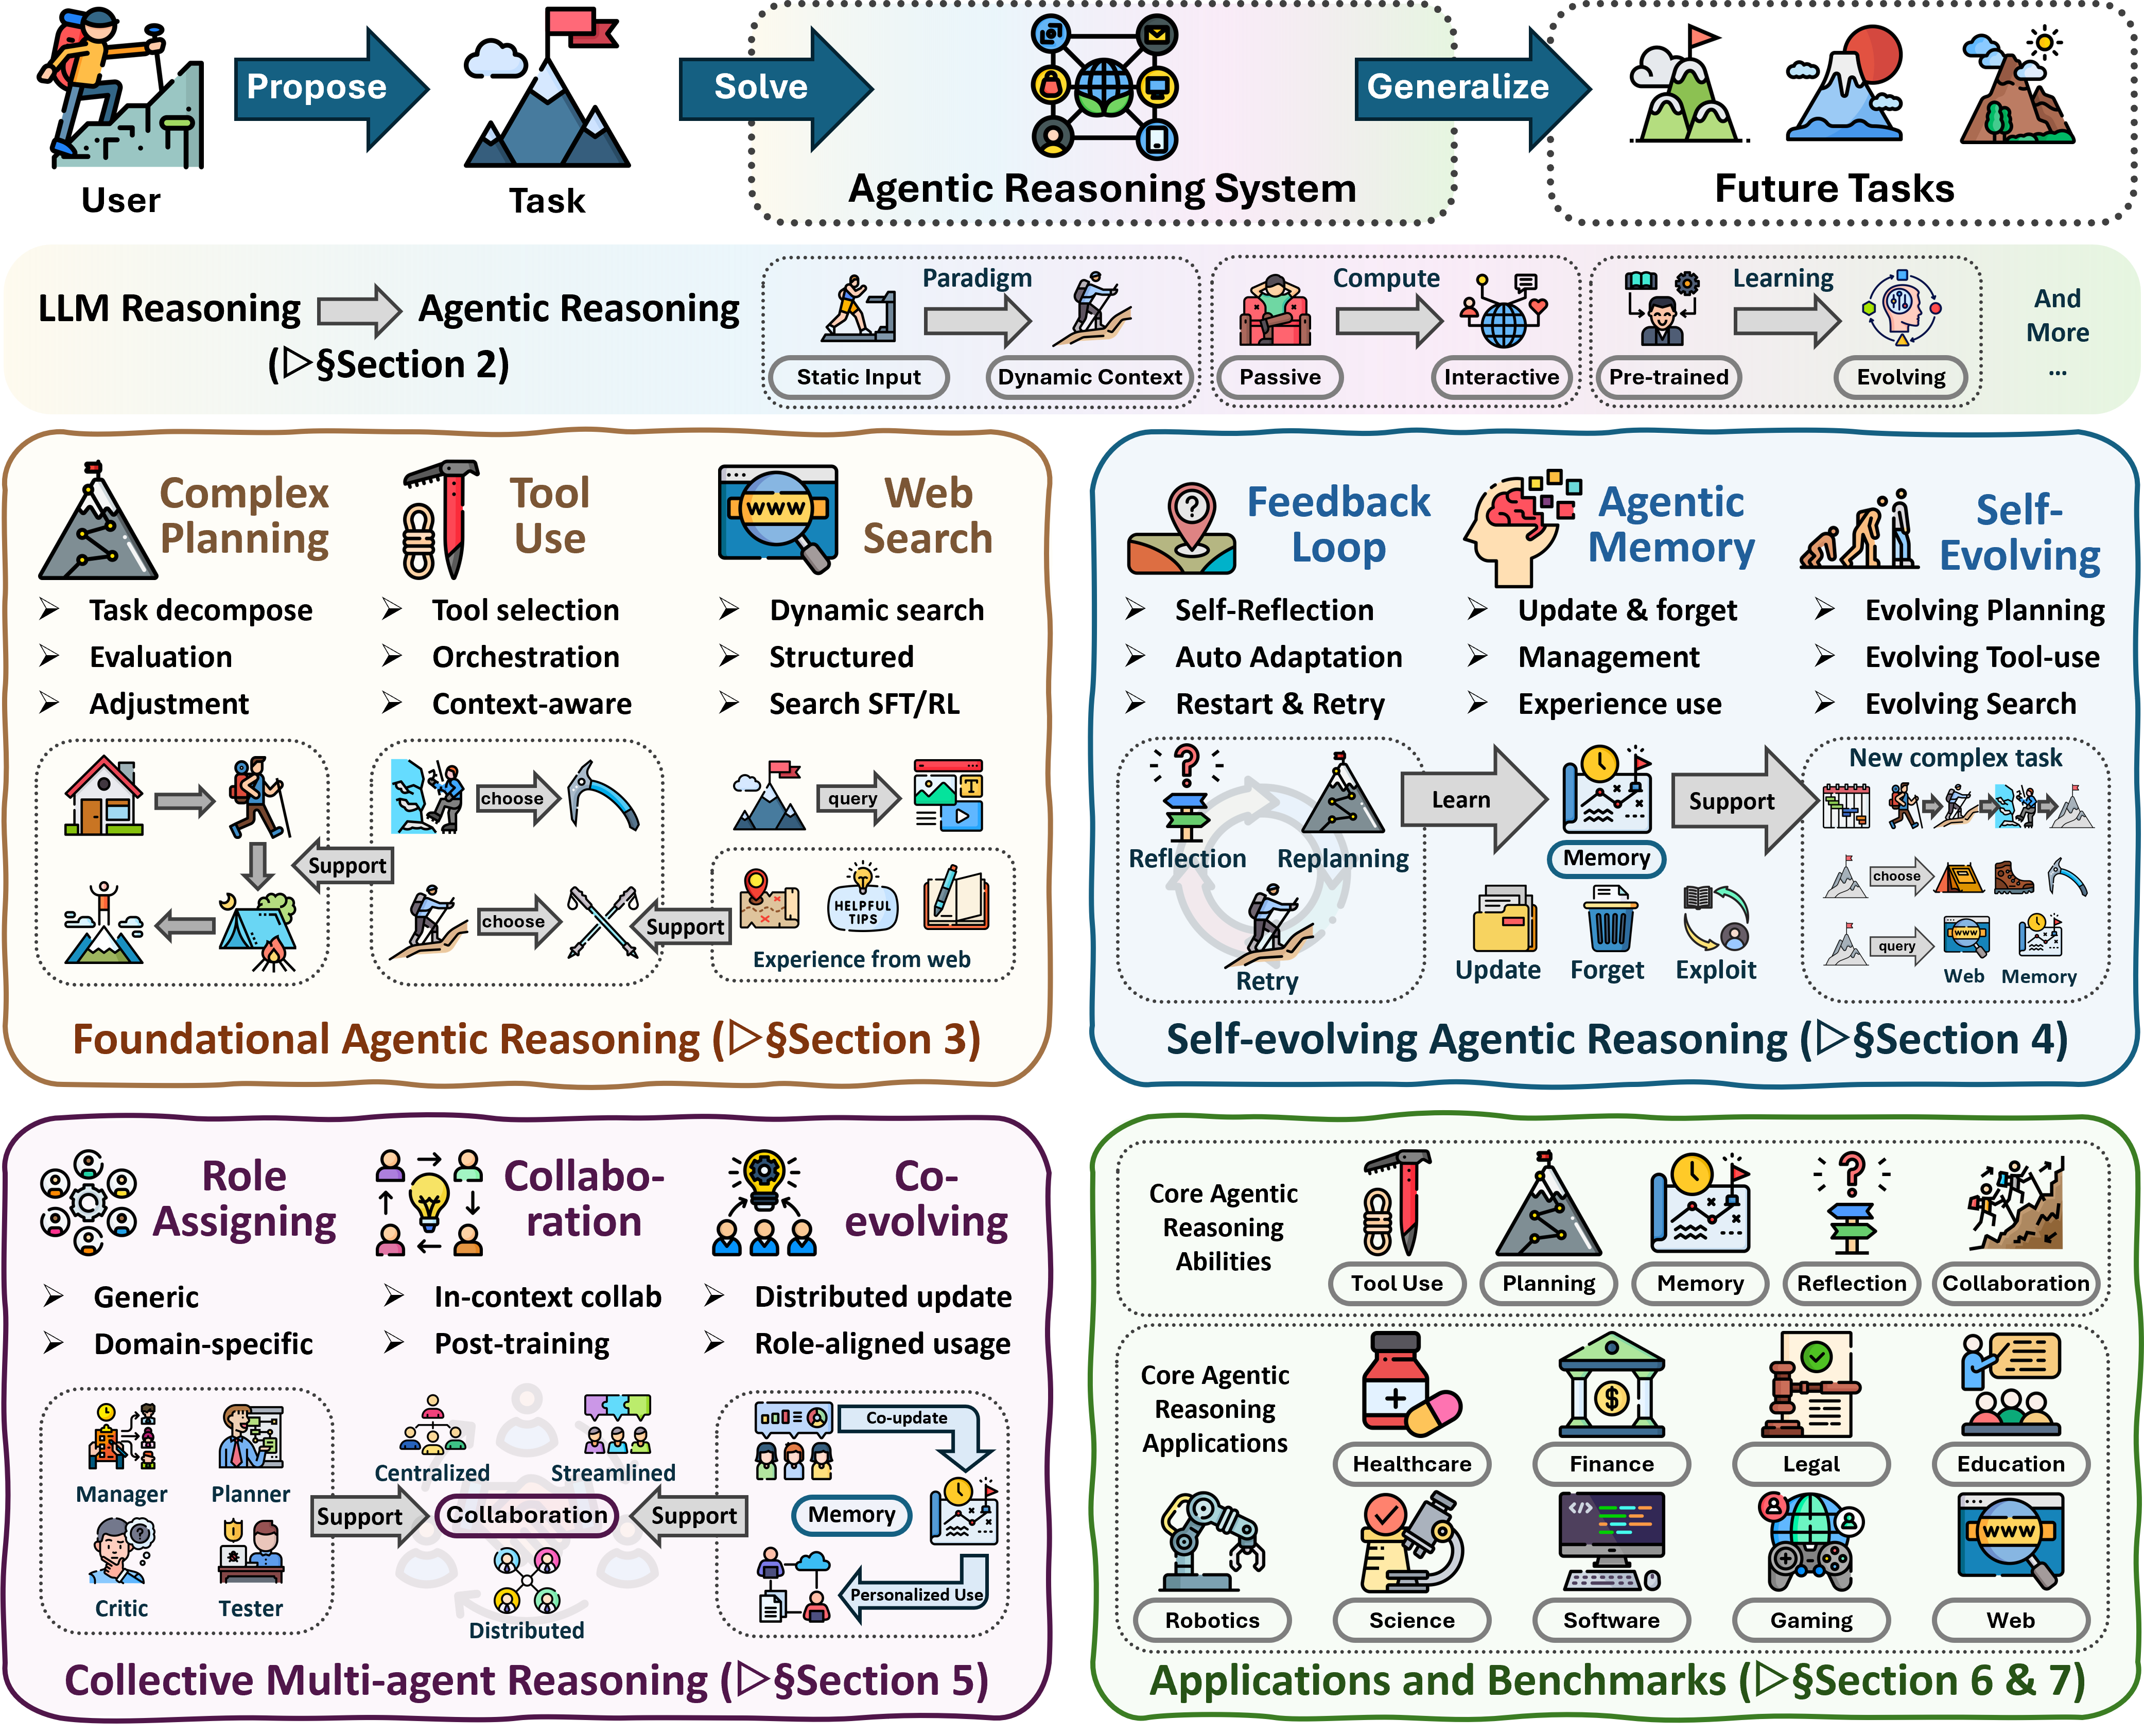

论文将 Agentic Reasoning 分为三个层次,并使用两种优化方式贯穿各层。
| 研究范围 | 关注的问题 | 主要组成 |
|---|---|---|
| Foundational Reasoning:基础推理 | 一个 Agent 如何完成当前任务 | 规划、工具使用、搜索 |
| Self-Evolving Reasoning:自我演进 | 反馈与经验如何改善后续决策 | 反馈、记忆、能力适应 |
| Collective Reasoning:群体推理 | 多个 Agent 如何共同完成任务 | 角色、协作、共享记忆与演进 |
| 优化设置 | 改变什么 | 参数是否更新 |
|---|---|---|
| In-Context | 当前推理路径、上下文、工具与工作流 | 通常保持底层模型参数固定 |
| Post-Training | 生成推理和动作的策略 | 通过 SFT、RL 等方法更新参数 |
这里有一个很容易混淆的地方:三个 Level 并不是严格递进的产品成熟度等级。
它们实际上是三类相互关联的研究范围:基础能力、跨时间的自适应能力、多个 Agent 之间的协同能力。一个单 Agent 系统也可以具备很强的自演进能力;一个多 Agent 系统也可能只是简单调用多个固定 Prompt。
这套框架的价值在于,我们可以用同一套坐标理解 ReAct、LangGraph、工具使用强化学习、Agent Memory,以及 Multi-Agent 系统,而不再把它们看作彼此割裂的技术。
二、论文的理论基础:将 Agent 建模为序贯决策系统
对应原文第 2.2 节:把状态、观察、推理和行动放进同一个建模框架。
作者尝试用 POMDP(部分可观测马尔可夫决策过程)统一表达 Agentic Reasoning。
1. Agent 的核心数学定义
沿用论文的策略分解:
其中:
| 符号 | 含义 | 举例 |
|---|---|---|
| 环境真实状态,可能无法完全观测 | 整个代码仓库的真实缺陷 | |
| 当前可观测信息 | 报错日志、测试结果 | |
| 截至当前的交互历史 | 之前读过的文件、执行过的命令 | |
| 内部推理、决策或计划 | 判断应该检查哪个模块 | |
| 对外执行的动作 | 读取文件、运行测试、修改代码 | |
| 内部记忆或上下文状态 | 当前已确认的事实和任务进度 | |
| 环境反馈产生的奖励 | 测试通过、任务成功 |
在这个分解中,推理 与行动 被明确区分了。
模型可以先思考,再选择执行动作;动作改变环境,产生新的观察,随后进入下一轮决策。
2. 一个具体例子
假设给 Agent 一个目标:修复 GitHub 仓库中的某个 Bug。
| 时刻 | 思考 | 行动 | 新观察 |
|---|---|---|---|
| 需要先定位故障 | 读取报错日志 | 获取堆栈信息 | |
| 可能是参数类型问题 | 检查相关函数 | 发现类型不匹配 | |
| 修改函数并验证 | 修改代码、执行测试 | 测试失败 | |
| 原来的假设不完整 | 分析失败用例 | 发现边界条件 | |
| 修复边界逻辑 | 再次修改并测试 | 测试通过 |
这个例子揭示了两个关键问题:
第一,Agent 的后续决策由不断更新的信息驱动。
第二,真正的 Agent Reasoning 不只是“如何解题”,还包括“下一步获取什么信息最有价值”。
论文将整体目标写为最大化长期累积奖励:
意思是:Agent 应当优化整个任务的效果,而不仅是某一步生成结果的正确性。
3. In-Context 与 Post-Training 到底区别在哪?
这是全文第二个核心理论轴。
In-Context:优化当前任务的推理轨迹。
模型参数固定,通过提示词、搜索、工作流、工具调用等方法,寻找更好的决策序列。
例如让同一个模型搜索五条解决方案,验证后选择最好的方案。
Post-Training:优化生成推理轨迹的策略。
不再满足于每次都额外搜索,而是通过训练,让模型更容易生成正确的计划和动作。
例如收集大量成功、失败的工具调用轨迹,然后进行 SFT 或 RL,使模型学会何时搜索、何时执行和何时停止。
论文以 GRPO 为代表说明策略优化:从同一个问题采样多个候选轨迹,根据相对奖励构造优势信号,再调整生成策略。这里省略了裁剪、参考策略约束等完整训练目标,不能把这个描述直接当作实现。
两者并不矛盾:推理阶段的搜索可以产生训练数据,训练后的模型也仍然可以继续进行搜索。
这是 Agent 推理训练和推理时计算之间的重要联系。
三、Foundational Reasoning:Agent 的基础能力
对应第3章。这一章可以概括为三个核心问题:
| 能力 | 需要解决的问题 | 决策对象 |
|---|---|---|
| Planning | 接下来应该做什么? | 任务分解与动作顺序 |
| Tool Use | 应该调用哪个工具、如何调用? | 工具选择与执行 |
| Agentic Search | 还缺什么信息、到哪里找? | 信息获取策略 |
3.1 Planning:规划不是简单列任务清单
论文将规划技术划分成几种主要路线。
第一类:Workflow Design,工作流设计。
人为或自动把任务组织成阶段,例如:
理解问题 → 制定计划 → 执行 → 验证 → 修正
代表方法包括 ReAct、ReWOO 以及各种 Planner–Executor 系统。
这种方法的优势是结构清楚,比较适合有明确业务流程的任务;缺点是在遇到超出预期的状态时,固定工作流可能缺乏灵活性。
第二类:Tree Search,搜索式规划。
不再只产生一条计划,而是产生多条候选路径,并在路径之间进行选择。
论文讨论了 BFS、DFS、A*、Beam Search、MCTS,以及 Tree-of-Thoughts、Graph-of-Thoughts 等代表方法。
例如对当前状态 ,模型可以生成多个候选动作:
然后利用评估函数估计动作的价值,选择有希望的路径继续展开。
这类方法的核心价值是具备一定的前瞻能力,可以探索、回溯、比较,而不必完全依赖模型第一次生成的决策。
但它面临一个难点:谁来可靠地评估尚未执行的计划?
如果价值评估同样依赖存在错误的 LLM,搜索规模变大并不必然提高正确率。
第三类:Process Formalization,形式化规划。
将自然语言计划转化为更严格的表示,包括程序、PDDL、逻辑约束等。
例如把:
“先完成身份验证,再执行数据更新”
转化为带有前置条件与状态转移的可执行操作。
这样就能用现有的规划器或约束检查器验证计划是否可执行,而不是仅仅判断计划文本是否合理。
第四类:Decoupling / Decomposition,解耦与分解。
将问题分成目标识别、任务分解、执行、验证等相对独立的模块。
第五类:External Aid,外部辅助。
利用知识图谱、检索系统、世界模型等辅助制定计划。
第六类:Reward-Based Planning,基于奖励的规划。
使用强化学习和控制优化,让 Agent 根据长期任务回报改进规划行为。
这六类技术并不完全互斥。例如,一个系统可以同时使用任务分解、MCTS 和形式化验证。
3.2 Tool Use:从会调用 API 到自主掌握工具
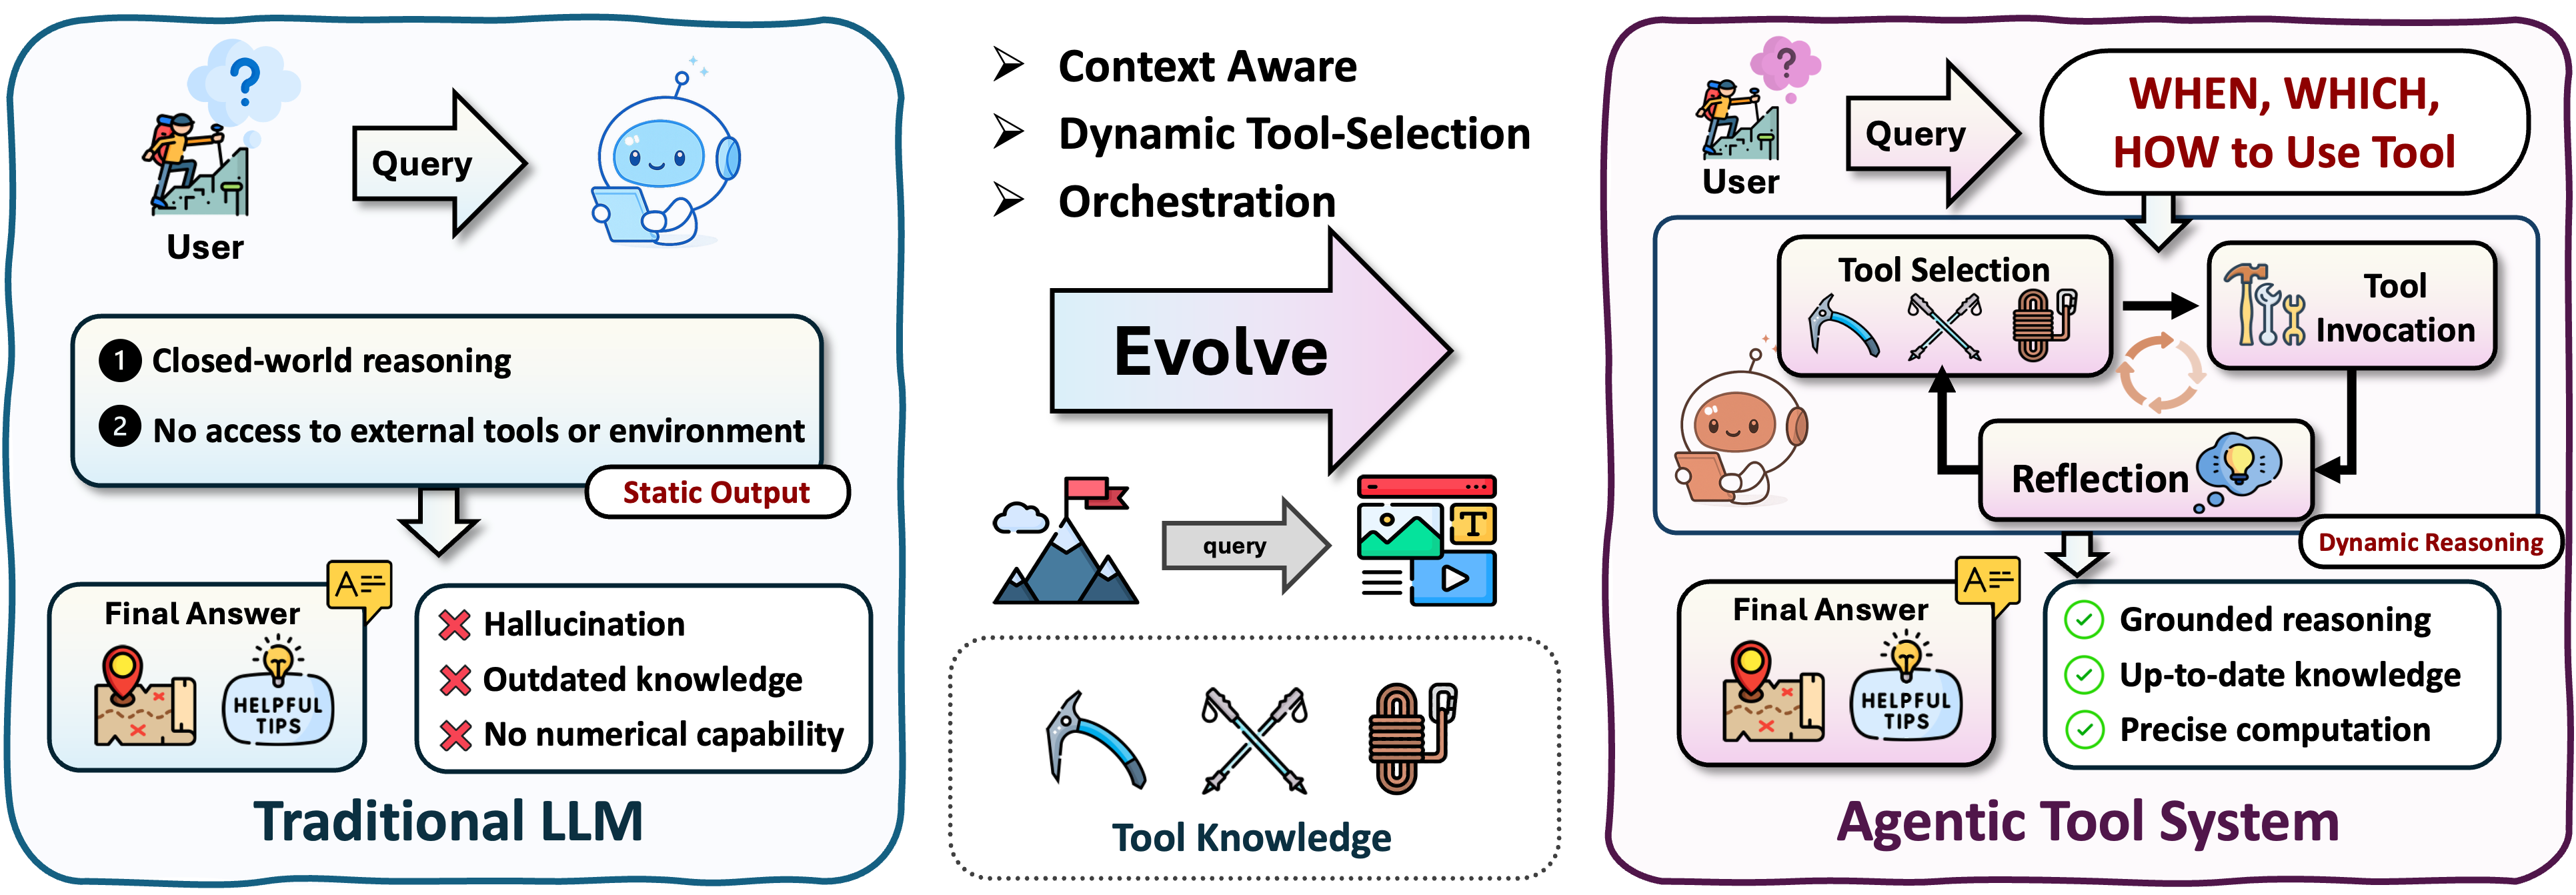

论文指出,工具使用的研究已经从简单函数调用发展到三个不同层面。
| 层面 | 技术路线 | 代表方法 |
|---|---|---|
| 推理时调用 | 通过 Prompt 和少量示例学习工具使用 | ReAct、ART、GEAR |
| 训练工具策略 | SFT / RL 学习选择与调用工具 | Toolformer、ToolLLM、ToolRL |
| 工具编排 | 规划多工具依赖和执行顺序 | HuggingGPT、ToolPlanner、OctoTools |
Function Calling 只覆盖工具使用链路中的一部分。
Function Calling 解决的是模型如何生成工具调用请求;完整的 Tool-Use Reasoning 还需要回答:
- 什么时候应该调用工具,而不是直接回答?
- 多个工具都能完成任务时,选哪个?
- 如何使用前一个工具的结果决定下一个工具?
- 如何判断工具结果可信?
- 调用失败后应该重试、换工具还是重新规划?
更高级的研究还在尝试让 Agent 创建新工具,而非只能从预定义的 API 列表中选择。
例如 LATM、CRAFT、CREATOR、ToolMaker 等工作探索通过代码生成和工具复用扩展 Agent 的能力边界。
这种能力非常接近人类解决陌生问题的方式:现有工具不够用,就先制造工具。
3.3 Agentic Search:从检索文档到主动获取证据
| 对照场景 | 流程 | 检索的地位 |
|---|---|---|
| 固定流程的 RAG | 问题 → 检索 → 汇总证据 → 回答 | 预先定义的处理步骤 |
| Agentic Search | 判断信息缺口 → 搜索 → 评估证据 → 再搜索或回答 | 可持续选择、调整和终止的动作 |
论文重点梳理了三类方法:
| 技术路线 | 代表工作 | 核心机制 |
|---|---|---|
| In-Context Search | Self-Ask、IRCoT、DeepRAG | 推理与搜索交替进行 |
| Post-Training Search | Search-R1、Deep-Researcher、ReSearch | 通过训练学习搜索决策 |
| Structure-Enhanced Search | Agent-G、GeAR、MC-Search | 引入知识图谱或结构化、多模态证据 |
其中我认为 Search-R1 / Deep-Researcher 这条路线值得重点关注。
传统方法通过 Prompt 要求模型搜索,而这些方法试图通过 RL 让模型自己学会何时搜索、搜索什么以及如何根据证据继续推理。
换句话说:
传统 RAG 也可以优化查询、重排和生成;这里采用固定检索流程作为对照,Agentic Search 进一步把检索时机、查询改写与停止条件作为决策对象。
这也自然引出了信息价值(Value of Information)问题:
在当前状态下,再执行一次搜索,预期能提高多少最终任务成功率?这一收益是否值得额外的成本?
这是从论文分类可以进一步抽象出的一个很有价值的研究问题。
四、Self-Evolving Reasoning:Agent 如何真正变得更强?
对应第4章。
这一章需要分清三个问题:当前尝试是否改对了、跨任务是否积累了经验、模型参数是否真的被更新。
很多系统声称自己具备 Self-Improvement,但实际上只是失败后重新生成一次。
论文对此进行了比较明确的区分。
4.1 Feedback:三种反馈机制
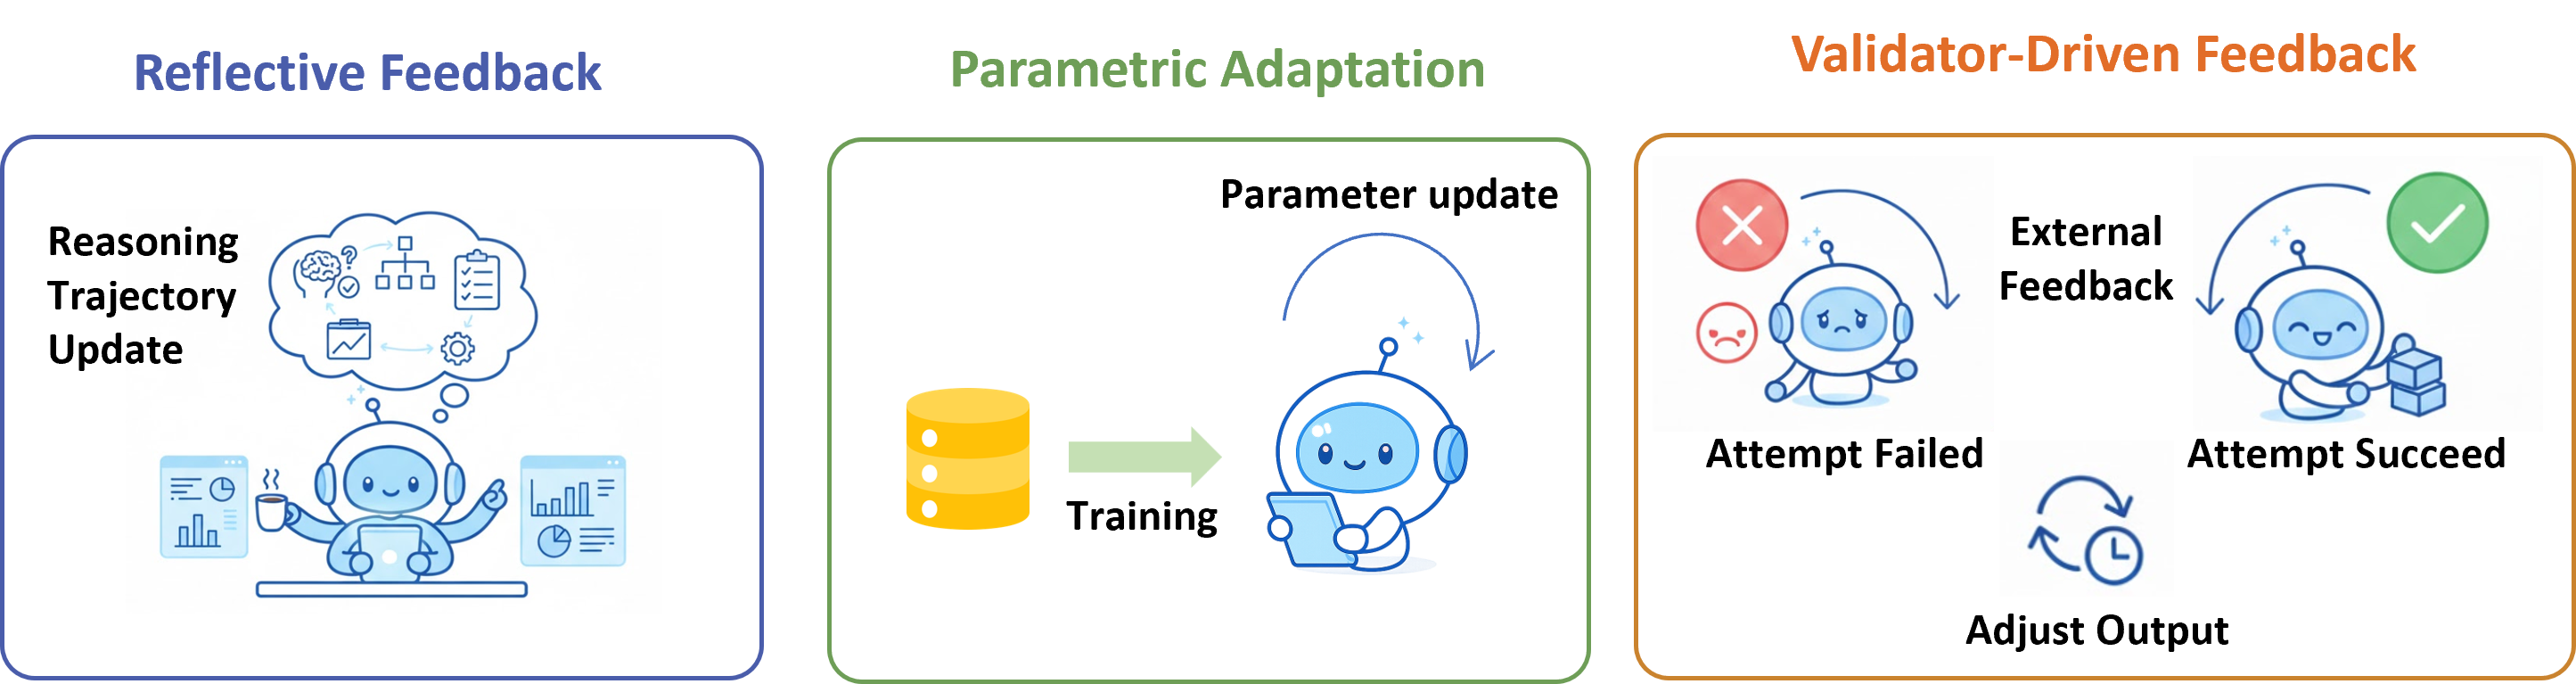

| 反馈类型 | 改变什么 | 是否更新模型参数 | 典型方法 |
|---|---|---|---|
| Reflective Feedback | 当前推理或行动轨迹 | 否 | Reflexion、Self-Refine |
| Parametric Adaptation | 模型策略本身 | 是 | AgentTuning、ReFT |
| Validator-Driven Feedback | 本轮候选输出的接受或拒绝 | 否 | 单元测试、执行验证、Retry |
理解它们最简单的方法,是看一次失败之后系统如何处理。
假设 Agent 写了一段代码,测试失败。
Reflective Feedback:
模型阅读报错,分析原因,针对错误修改代码。
Parametric Adaptation:
将失败和修正后的轨迹收集为训练样本,利用 SFT 或 RL 改进后续任务中的模型行为。
Validator-Driven Feedback:
把完整候选提交给外部检查器,失败则丢弃或重新采样,直到通过检查。在论文讨论的典型形式中,验证器仅提供接受或拒绝,而不诊断错误。
其中 Validator-Driven Feedback 很值得注意:它不一定需要模型理解错误原因。
只要存在可靠且成本可接受的验证器,通过生成多个候选并筛选,也可能取得较强效果。
但这里有一个重大限制:
反思的质量并不天然可靠。
一个会犯错的模型,即使被要求检查自己的推理,也不一定能识别错误。外部证据、程序执行结果、约束检查和独立验证通常比单纯的自我肯定更值得信赖。
论文强调了反馈机制,至于不同反馈源的可信度、误报率和跨环境稳健性,则仍有很大研究空间。
4.2 Agentic Memory:Memory 不等于数据库
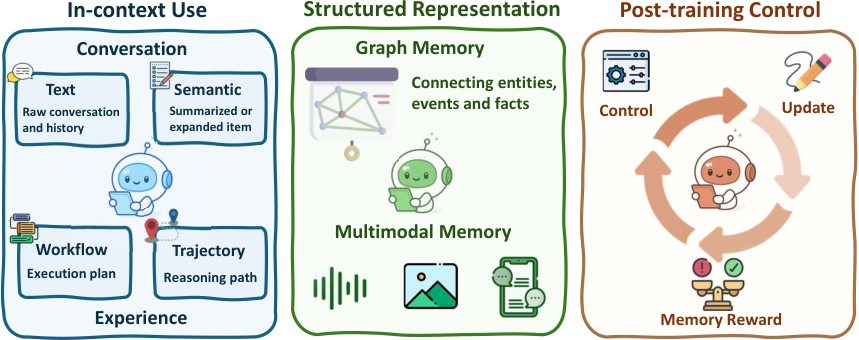

这是第4章的另一核心。
论文从记忆内容、表示方式与控制方式梳理 Agent Memory。下面四个方面可以同时存在,不是必须依次经历的产品阶段。
事实记忆:保留发生过什么。
存储用户信息、历史对话、文档内容,主要解决信息保留和检索的问题。
代表系统包括 MemGPT、MemoryBank 等。
经验记忆:保留怎样解决问题。
存储过去如何成功解决问题,例如失败案例、成功计划、工具调用轨迹和可复用工作流。
代表方向包括 Workflow Memory、Reasoning Bank、Dynamic Cheatsheet。
区别非常重要:
事实记忆回答“过去发生了什么”,经验记忆进一步回答“遇到类似问题应该怎样做”。
结构化记忆:保留关系和依赖。
通过图、树、工作流、多模态结构保存依赖关系。
例如知识图谱存储实体关系,工作流图记录先后依赖,多模态记忆记录视觉场景和动作历史。
学习式记忆控制:决定何时读、写、更新和删除。
不再由开发者固定规定何时保存、检索或删除记忆,而是把记忆管理也视为 Agent 的决策问题。
这条路线的代表工作包括 Memory-R1、MemAgent、Memory-as-Action、MemRL。
记忆管理也可以是一个强化学习问题
Agent 根据当前任务和记忆状态选择操作,并以未来任务效果、检索成本和记忆污染风险来评价决策。这是对论文中学习式记忆控制思路的简化表达。
这意味着,记忆管理不再只是向量检索、摘要压缩或者上下文截断,而是需要判断:
什么经验值得积累、积累后是否真的改善未来决策,以及什么时候应该遗忘。
一个值得进一步研究的问题是,如何避免 Agent 将错误结论沉淀成持久记忆,并在之后的任务中反复使用。
从安全角度看,记忆甚至可能成为比单次输出更重要的风险传播渠道。
4.3 自我演进的三个层次
论文使用一个统一形式描述 Agent 如何跨任务更新自身:
其中 是 Agent 可以持续更新的系统状态, 是完成的任务轨迹, 是获得的反馈。
这个公式最关键的地方是:被更新的对象不一定是模型参数。
| 演进对象 | 变化形式 | 代表方向 |
|---|---|---|
| Verbal Evolution | 更新提示词、反思、经验规则 | Reflexion |
| Procedural Evolution | 增加或优化可复用的工具、技能 | Voyager |
| Structural Evolution | 修改工作流、代码或 Agent 架构 | AlphaEvolve 等 |
例如,一个 Agent 第一次遇到复杂 Excel 处理任务,需要大量临时推理和代码调用;完成后,它将成功步骤封装成可复用 Skill。
以后遇到类似任务,可以直接调取这段 Skill。
即使底层模型参数没有变化,系统整体也获得了新的能力。
但从科研角度,仍然必须区分:这种提升究竟是记忆命中、环境缓存还是可泛化的能力提升。
论文还强调了两个演进时间尺度:在一次任务内部持续修正,以及跨多次任务积累能力。这比笼统地说“Agent 能自我学习”更加准确。
五、Collective Multi-Agent Reasoning:多 Agent 的核心不是角色扮演
对应第5章。
这部分论文讨论的重点,不只是让几个 LLM 相互对话,而是如何通过分工、通信、记忆和训练,产生单 Agent 无法轻易获得的系统能力。
5.1 多 Agent 的五类基本角色
论文总结了五种通用角色。
| 角色 | 核心职责 | 典型功能 |
|---|---|---|
| Leader / Coordinator | 目标管理和任务分解 | Planner、Orchestrator |
| Worker / Executor | 完成具体任务 | 调用工具、执行代码 |
| Critic / Evaluator | 检查输出和执行结果 | Verifier、Judge、Tester |
| Memory Keeper | 管理共享与长期记忆 | Memory Manager |
| Communication Facilitator | 管理信息传递和通信规则 | Router、消息协调器 |
以软件开发为例:
Manager 负责分解需求,Developer 编写代码,Tester 执行测试,Reviewer 审核变更。
不过,论文并没有认为角色越多越好。
真正重要的是,角色之间是否形成有效的认知分工,以及分工收益是否大于额外的通信和执行成本。
5.2 Multi-Agent Collaboration 的技术路线
论文将协作系统大体划分为两种范式。
范式一:In-Context Collaboration
不需要重新训练模型,通过工作流设计、Prompt 和动态编排实现协同。
典型方法包括:
- MetaGPT、ChatDev:预先定义角色与协作流程。
- Magentic-One:由中心 Orchestrator 动态协调专业 Agent。
- AgentRouter:根据任务条件选择合适的专业 Agent。
这种方法更接近当前大量工程系统采用的路线。
范式二:Post-Training Collaboration
将 Agent 之间的合作本身作为需要优化的对象。
例如,一个多 Agent 系统可以表示成图:
其中 是 Agent 集合, 表示通信或任务依赖关系。
系统不再固定要求所有 Agent 按某个预定顺序交互,而是试图学习最优通信结构。
论文讨论了两条路线:
| 路线 | 核心思想 | 代表工作 |
|---|---|---|
| Graph-Based Topology | 搜索、生成或剪枝 Agent 通信图 | AFlow、GPTSwarm、AgentPrune |
| Policy-Based Topology | 学习动态选择 Agent 的策略 | MAGRPO、MHGPO、MAPoRL |
这里最有意思的研究问题是:
给定一个任务,应当让哪些 Agent 参与、以什么顺序协作、交换哪些信息,才能最大化质量并最小化成本?
这已经不再是简单的 Prompt Engineering,而是一个涉及图优化、序贯决策和强化学习的问题。
5.3 Multi-Agent Evolution:从协作到共同演进
论文进一步将多 Agent 的演进分为两个维度。
一个是时间尺度:任务内适应,还是跨任务长期学习。
另一个是更新对象:更新模型、工作流、共享记忆,还是 Agent 之间的通信结构。
尤其值得关注的是 Multi-Agent Credit Assignment(多智能体信用分配)。
假设三个 Agent 共同完成任务:
最终结果错误。
问题来了:
到底是 的规划错误, 的执行错误,还是 的验证不足?
只用最终任务成功或失败作为奖励,无法准确判断每个 Agent 的贡献。
这在多 Agent 强化学习中非常关键。论文讨论了 MARFT、Stronger-MAS、MALT、MAPoRL 等尝试优化协作训练与奖励分配的方法。
此外,共享记忆也产生了新的问题:一个 Agent 的错误经验可能被整个团队复用;局部改进不一定提高整体任务成功率。
我认为这里可以提炼出一个非常重要的结论:
Multi-Agent 的协作结构、信息流和团队决策,都需要可以被优化与验证。
六、应用与 Benchmark:论文如何评价 Agent 的能力?
论文第6章和第7章覆盖了大量具体应用。我将它们压缩成一张便于研究选题的表格。
6.1 五大应用方向
| 领域 | 代表系统 | 最核心的技术挑战 |
|---|---|---|
| 数学与编程 | OpenHands、数学探索 Agent、代码修复系统 | 长任务规划、可执行验证 |
| 科学发现 | AI Scientist-v2、PaperQA2、Coscientist | 假设生成、实验执行、证据可靠性 |
| 具身智能 | Voyager、SayCan、Gemini Robotics | 状态感知、物理规划、动作反馈 |
| 医疗健康 | MDAgents、EHRAgent、MedAgents | 高风险决策、证据整合、长期状态 |
| Web / GUI / Research | WebSailor、Agent S、DeepResearcher | 动态环境、复杂工具链、长程任务 |
这里的共性是:Agent 需要在现实环境约束下完成任务,而不只是生成看起来合理的文本。
论文没有把这些系统放在同一实验条件下直接比较。它们主要用于说明三层 Agentic Reasoning 如何在不同领域落地。
6.2 哪些 Benchmark 最值得关注?
| 评估能力 | 推荐了解的 Benchmark | 主要测试什么 |
|---|---|---|
| 规划 | PlanBench、ACPBench、ALFWorld | 动作前置条件、规划有效性、环境交互 |
| 工具调用 | ToolBench、API-Bank、T-Eval | 工具选择、多步调用、执行正确性 |
| Agentic Search | Mind2Web 2、WideSearch、MMSearch | 搜索策略、证据整合、多模态搜索 |
| 长期记忆 | LongMemEval、LOCOMO、MemoryAgentBench | 跨会话记忆、更新、冲突处理 |
| 软件与桌面 | SWE-bench、OSWorld | 真实代码或桌面任务完成能力 |
| Web Agent | WebArena、VisualWebArena | 浏览器操作、状态追踪、目标完成 |
| 科学研究 | ScienceAgentBench、MLAgentBench | 实验规划、执行、验证 |
| 多 Agent | MultiAgentBench、Melting Pot | 协调、合作、竞争与通信 |
这里区分了论文中的能力级和应用级基准,也补充了文中其他章节涉及的 SWE-bench。不同 Benchmark 的任务、规模和评分方式不同,不宜直接比较分数。
我认为论文在 Benchmark 部分传达了一个值得认真对待的观点:
Agent 最终成功率并不足以解释 Agent 为什么成功或失败。
例如,软件开发 Agent 失败,可能因为定位错误、计划不合理、调用工具出错、上下文丢失,甚至没有正确理解测试反馈。
因此,评测应该分为两个层次。
一层是端到端指标,例如 Task Success Rate、完成时间、Token Cost、工具调用次数。
另一层是过程指标,例如规划正确性、证据质量、错误恢复能力、记忆有效性、单步动作可靠性。
这也是我认为未来 Agent Reliability 研究必须重视的方向。
七、论文提出的六个未来研究方向
第8章直接列出了六个 Open Problems。我把原文论点和潜在研究切入点放在一起。
- User-Centric Agentic Reasoning
个性化 Agent 不仅需要记住用户信息,还要在持续交互中学习用户目标、偏好和反馈,并平衡短期任务奖励与长期信任。难点是用户目标本身也可能变化。
- Long-Horizon Agentic Reasoning
长程任务中的错误不断累积,而最终奖励难以指导具体步骤。尤其缺乏能够跨 Token、工具调用、技能和记忆更新进行信用分配的通用方法。
- Agentic Reasoning with World Models
让 Agent 利用内部环境模型预测行动后果,进行前瞻性规划。难点是环境模型的校准、迁移以及环境变化后的持续更新。
- Multi-Agent Collaborative Training
学习自适应协作结构,解决团队奖励分配、协调开销和动态通信问题,而不是依赖人工编排固定的专家团队。
- Latent Agentic Reasoning
在连续隐空间中完成部分规划和决策,减少对显式语言推理的依赖。潜在优势是效率,核心问题是可解释性与可审计性。
- Governance of Agentic Reasoning
从模型输出安全扩展到行动安全、工具权限、长期记忆与多 Agent 协作治理。错误可能跨越多个步骤与组件,必须建立可追溯和可约束的机制。
以上是论文原文明确列出的方向,而不是我额外推测的趋势。
八、如何评价这篇综述的学术价值?
8.1 三个主要贡献
第一,统一了 Agentic Reasoning 的研究视角。
Agent 相关研究极其分散:有人研究 Prompt,有人研究工具调用,有人研究强化学习、Memory、Multi-Agent。
这篇论文把它们统一为“通过持续交互实现目标导向的推理”这一核心问题。
它提供了一张研究地图,没有提出一个可以直接替代现有系统的通用 Agent 算法。
第二,区分推理阶段优化与训练阶段优化。
这一点尤其重要。
很多工程 Agent 的进步来源于更好的 Harness、工作流和外部工具,但另一条路线是通过强化学习直接改善模型的工具策略。
这篇论文将它们放进了同一个框架,有助于判断某个技术进展究竟来自模型本身,还是系统设计。
第三,把 Self-Evolving 与 Multi-Agent Training 纳入核心讨论。
这避免了将 Agent 简单理解为 LLM + Tools。
真正的长期目标是使 Agent 能持续积累能力、适应环境并形成有效的集体协作。
8.2 三个主要不足
| 不足 | 具体问题 | 我的评价 |
|---|---|---|
| 分类边界不够严格 | Planning、Search、Memory、Reflection 之间存在明显重叠 | 适合建立知识地图,不适合作为完全互斥的技术分类 |
| 缺少统一实证比较 | 大量列举工作,但没有在统一实验下量化不同技术路线的收益与成本 | 难以直接依据综述决定最佳技术路线 |
| 对可靠性的建模不够系统 | Verification 分散在反馈、工具使用、规划、安全等章节 | 没有建立统一的过程可靠性框架 |
尤其是第三点。
论文的核心数学框架关注最大化预期任务回报,但对于任务过程中的风险传播、证据可信度和验证资源分配,尚未进行系统建模。
例如:
- 在哪一步应该插入验证?
- 一个子任务失败对最终任务的风险影响有多大?
- Agent 应当在什么时候停止尝试?
- 新增一个 Critic Agent 是否真的提高系统可靠性?
这些问题贯穿多个章节,却没有被收束成一个独立而统一的研究范式。
这些局限不等于综述结论不成立。它反映了论文重在梳理 Agent 推理能力,而非专门研究可靠性。
另外,第2.2节的 POMDP 和 Meta-Update 更适合作为概念性统一建模,不能据此认为论文已经给出了一个完整可训练的通用 Agent 算法。
九、延伸讨论:从答案检测到决策轨迹可靠性
以下是基于综述的研究设想,不是论文已经验证的结果。讨论重点从“最终回答有没有错”,移到“执行过程中能否提前发现风险,并用有限预算改变后续行动”。
9.1 首先重新定义研究问题
传统幻觉检测:
输入问题与回答,预测回答是否存在错误。
Agent Reliability 可以扩展为:
即:给定已经发生的推理、工具调用和环境反馈,预测整个任务在未来失败的风险。
这是一个更加自然的序贯风险估计问题。
9.2 三条可行研究路线
方向 A:Agent Trajectory Risk Estimation
目标:过程级失败预测
将每个动作视为风险评估节点,研究哪些局部信号能够预测最终任务失败。
可以利用的信号包括:动作类型、工具错误、计划变更、执行反馈、模型内部不确定性,以及历史验证结果。
核心实验应比较单步风险预测、提前预警能力和端到端失败预测,并控制额外推理成本。
方向 B:Risk-Aware Verification Scheduling
目标:让 Agent 知道什么时候值得验证
验证每一步会增加成本,而仅验证最终答案可能太晚。
因此可以研究一个决策策略:
根据预估风险以及验证成本,决定是否执行检查。
研究应考察在有限验证预算下,如何最大化任务成功率。
方向 C:Multi-Agent Failure Attribution
目标:定位导致团队任务失败的关键节点
对多 Agent 系统中的规划、执行、信息传递和验证节点建立贡献或依赖模型。
研究问题是:哪些步骤的失败最容易传播,以及在固定预算下优先修复哪些节点最有效。
这需要明确 Agent 间的信息依赖,并通过干预实验区分相关性与真正的失败原因。
9.3 先把轨迹风险估计做成可复现的问题
理由是它更容易形成明确、可复现的科学问题。
可以设计如下研究任务:
| 要素 | 具体设计 |
|---|---|
| 输入 | 单 Agent 或多 Agent 的部分执行轨迹 |
| 预测目标 | 后续失败概率、最终任务是否成功 |
| 预测时机 | 工具调用前、调用后、阶段切换时 |
| Baseline | 可用时使用 Token NLL、Entropy;另设 LLM Judge、轨迹特征分类器 |
| 数据环境 | WebArena、ALFWorld、软件开发 Agent 轨迹 |
| 指标 | AUROC、AUPRC、风险校准、提前预警、检测开销 |
| 实际效用 | 相同成本下能否减少失败、降低无效调用 |
实验应以工具调用、执行日志、显式计划和环境观察等可观测记录为主,不把读取模型内部思维链当作前提。Token NLL、Entropy 只在能够获取相应 token 概率时使用;闭源接口没有提供这些信息时,应报告缺失并保留可复现的日志特征基线。
数据还应按任务或代码库划分训练与测试,避免把同一任务的重试轨迹分到两边。时间点 的风险预测只能使用当时已经出现的信息,不能读到最终答案或之后的测试结果。检测器、验证器和重试的成本都应计入预算。
需要设计一个重要的对照:风险预测效果提升,是否真的能转化为 Agent 决策质量提升?
如果只能预测失败,却无法有效改变后续行动,那么它可能只是一种运行监控技术。
如果能够通过预测引导验证、重规划或工具切换,并在固定成本下测得可重复的任务成功率提升,研究意义就更强。
上述三个方向都需要重新设计数据、对照和干预实验;预测分数更好不等于任务决策已经改善。
十、沿技术问题安排阅读顺序
这篇综述虽然非常全面,但不适合按照引用顺序把所有工作全部精读。
我建议抓住以下几条关键技术演进路线。
| 技术主线 | 优先读的代表工作 | 需要掌握的关键思想 |
|---|---|---|
| 交互式推理 | ReAct | 思考—行动—观察闭环 |
| 推理搜索 | Tree of Thoughts | 候选空间、搜索与价值评估 |
| 自我修正 | Reflexion | 反思反馈和跨尝试的经验复用 |
| 工具学习 | Toolformer | 将工具调用转化为可学习行为 |
| 搜索强化学习 | Search-R1 | 学习何时搜索、如何搜索 |
| 长期记忆 | Memory-R1、Reasoning Bank | 记忆控制与经验积累 |
| 多 Agent 结构优化 | AFlow、GPTSwarm | 将协作工作流作为搜索或优化对象 |
| Agent 强化学习 | WebRL、DeepResearcher | 基于多步交互轨迹优化 Agent 策略 |
这些工作不完全是最新发布的系统,但它们能帮助建立清晰的技术演进脉络。论文中后续的大量研究,都是在这些思想基础上增加训练、结构化表示、验证或自适应机制。
阅读之后,应当能回答的五个问题
| 问题 | 判断依据 |
|---|---|
| 这个系统为什么属于交互式推理? | 它是否依据环境反馈调整后续信息获取与行动,而非只延长单次文本生成? |
| 能力变化发生在哪里? | 区分上下文、工作流、工具和记忆的变化,与模型参数更新。 |
| 记忆是否真的改善未来任务? | 检查跨任务表现,排除仅仅命中历史记录或环境缓存的情况。 |
| 多 Agent 的额外成本是否值得? | 比较协作收益、通信成本、错误传播与单 Agent 基线。 |
| 失败能否提前被识别并改变? | 同时测量过程风险、验证开销和相同预算下的最终任务结果。 |
实际阅读时,可以先精读第 2.2 节的统一建模,再进入第 4 章的记忆与反馈、第 5.2–5.3 节的协作优化,最后用第 8 章的开放问题反查尚未解决的假设。选择具体方法之前,先明确任务环境、可观测反馈、验证器和计算预算。
来源与配图授权
查看论文、作者项目与配图许可
- Tianxin Wei, Ting-Wei Li, Zhining Liu, et al. A Survey of Agentic Reasoning for Large Language Models: Towards Recursively Self-Improving and Collective Agents. arXiv:2601.12538v2,2026-09-20。
- 作者维护的 Awesome Agentic Reasoning 项目:用于交叉核对研究分类和发表状态;论文解读固定以 v2 为准。
- 文中四张插图来自上述论文的 Figure 1、3、5、6,作者为 Tianxin Wei 等,按 CC BY 4.0 复用。图片只做无损格式转换,没有修改图中内容;中文解释及研究设想由本文整理。